문제 설정
PCA에서 우리는 원래의 데이터 포인트 $\boldsymbol{x}_n$ 과 최대한 유사하지만, 내재적 차원이 현저히 낮은 데이터 포인트 $\boldsymbol{x}_n$ 의 사영 $\tilde{\boldsymbol{x}}_n$ 을 찾는 데 관심이 있다. 그림 10.1은 이것이 어떤 형태일 수 있는지 보여주는 예시를 제공한다.
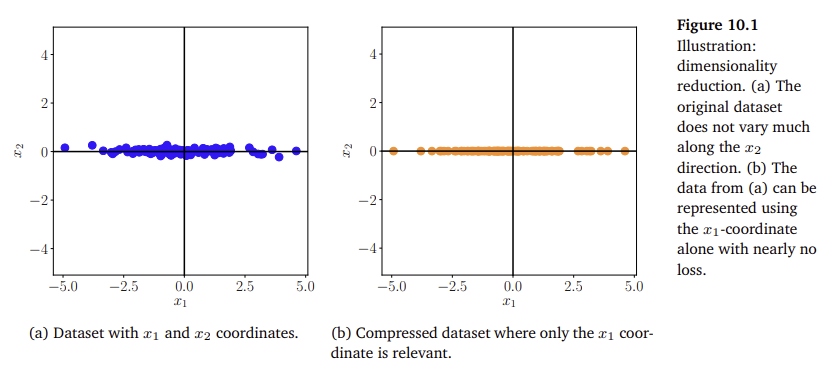
$\quad$ 보다 구체적으로, 평균이 $\boldsymbol{0}$ 이고 다음과 같은 데이터 공분산 행렬(6.42)을 가지는 i.i.d. 데이터셋 $\mathcal{X} = {\boldsymbol{x}_1, \dots, \boldsymbol{x}_N}, \boldsymbol{x}_n \in \mathbb{R}^D$ 를 고려한다.
식 (10.1)은 $\frac{1}{N}\boldsymbol{X}^\top\boldsymbol{X}, \boldsymbol{X} \in \mathbb{R}^{N \times D}$ 와 같다.
또한, $\boldsymbol{x}_n$ 의 저차원 압축 표현(코드)이 존재한다고 가정한다.
여기서 사영 행렬을 다음과 같이 정의한다.
우리는 $\boldsymbol{B}$ 의 열들이 정규 직교(정의 3.7)한다고 가정하며, 따라서 $i \neq j$ 일 때만 $\boldsymbol{b}_i^\top \boldsymbol{b}_j = 0$ 이고 $\boldsymbol{b}_i^\top \boldsymbol{b}_i = 1$ 이다. 우리는 데이터를 사영할 $M$ 차원 부분공간 $U \subseteq \mathbb{R}^D, \dim(U) = M < D$ 를 찾는다. 사영된 데이터를 $\tilde{\boldsymbol{x}}_n \in U$ 로 나타내고, ( $U$ 의 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 에 대한) 그 좌표를 $\boldsymbol{z}_n$ 으로 나타낸다. 우리의 목적은 사영 $\tilde{\boldsymbol{x}}_n \in \mathbb{R}^D$ (또는 동등하게 코드 $\boldsymbol{z}_n$ 과 기저 벡터 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ )을 찾아 원래 데이터 $\boldsymbol{x}_n$ 과 최대한 유사하게 만들고 압축으로 인한 손실을 최소화하는 것이다.
_ $\boldsymbol{B}$ 의 열 $\boldsymbol{b}_1, \dots, \boldsymbol{b}_M$ 은 사영된 데이터 $\tilde{\boldsymbol{x}} = \boldsymbol{B}\boldsymbol{B}^\top\boldsymbol{x} \in \mathbb{R}^D$ 가 존재하는 $M$ 차원 부분공간의 기저를 형성한다._
$\boldsymbol{B}$ 의 열들이 정규 직교하다고 가정하는 이유는 첫 번째로 데이터의 방향만을 고려하기 위함이고, 두 번째로 데이터를 압축할 때 각 주성분(축)이 독립적이여야 한다.
또, PCA의 기저 행렬 $\boldsymbol{B}$ 는 일반적인 정방행렬의 정규 직교행렬이 아니다. $D$ 차원 데이터를 $M$ 차원으로 압축하기 때문에( $M < D$ ), $B$ 는 세로로 긴 $D \times M$ 직사각 행렬이므로 일반적인 역행렬을 가질 수 없다. 비록 정방 행렬은 아니지만, $B$ 의 $M$ 개의 열벡터들은 서로 정규 직교하므로 자신들끼리 내적하면 단위 행렬이 된다. 즉 $B^\top B = I_M$ ( $M \times M$ 단위 행렬)이 성립한다.
예제 10.1 (좌표 표현/코드)
표준 기저 $\boldsymbol{e}_1 = [1, 0]^\top, \boldsymbol{e}_2 = [0, 1]^\top$ 를 가지는 $\mathbb{R}^2$ 를 고려한다. 2장으로부터 $\boldsymbol{x} \in \mathbb{R}^2$ 가 이 기저 벡터들의 선형 결합으로 표현될 수 있음을 안다. 예를 들어,
그러나 다음과 같은 형태의 벡터를 고려할 때,
이들은 항상 $0\boldsymbol{e}_1 + z\boldsymbol{e}_2$ 로 쓸 수 있다. 이 벡터들을 표현하기 위해서는 $\boldsymbol{e}_2$ 벡터에 대한 $\tilde{\boldsymbol{x}}$ 의 좌표/코드 $z$ 를 기억하거나 저장하는 것으로 충분하다.
$\quad$ 더 정확하게는, $\tilde{\boldsymbol{x}}$ 벡터들의 집합은 (표준 벡터 덧셈과 스칼라 곱셈과 함께) $U = \text{span}[\boldsymbol{e}_2]$ 이기 때문에 $\dim(U) = 1$ 인 벡터 부분공간 $U$ (2.4절 참조)를 형성한다.
벡터 공간의 차원은 기저 벡터의 수와 일치한다(2.6.1절 참조).
$\quad$ 10.2절에서는 가능한 한 많은 정보를 유지하고 압축 손실을 최소화하는 저차원 표현을 찾는다. PCA의 대안적 유도 과정은 10.3절에 제시되어 있으며, 여기서는 원본 데이터 $\boldsymbol{x}_n$ 과 그 사영 $\tilde{\boldsymbol{x}}_n$ 사이의 제곱 재구성 오차 $\Vert \boldsymbol{x}_n - \tilde{\boldsymbol{x}}_n\Vert ^2$ 를 최소화하는 과정을 살펴본다.
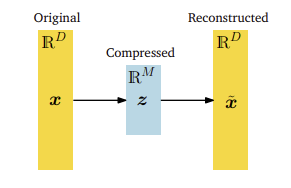
PCA의 그래픽적 묘사. PCA에서 원본 데이터 $\boldsymbol{x}$ 의 압축된 버전 $\boldsymbol{z}$ 를 찾는다. 압축된 데이터는 $\tilde{\boldsymbol{x}}$ 로 재구성될 수 있으며, 이는 원본 데이터 공간에 존재하지만 $\boldsymbol{x}$ 보다 내재적으로 더 낮은 차원의 표현을 가진다.
$\quad$ 그림 10.2는 PCA에서 고려하는 설정을 보여준다. 여기서 $\boldsymbol{z}$ 는 압축된 데이터 $\tilde{\boldsymbol{x}}$ 의 저차원 표현을 나타내며, $\boldsymbol{x}$ 와 $\tilde{\boldsymbol{x}}$ 사이에 얼마나 많은 정보가 흐를 수 있는지를 제어하는 병목(bottleneck) 역할을 한다. PCA에서는 원본 데이터 $\boldsymbol{x}$ 와 저차원 코드 $\boldsymbol{z}$ 사이의 선형 관계를 고려하므로, 적절한 행렬 $\boldsymbol{B}$ 에 대해 $\boldsymbol{z} = \boldsymbol{B}^\top\boldsymbol{x}$ 이고 $\tilde{\boldsymbol{x}} = \boldsymbol{B}\boldsymbol{z}$ 이다.
PCA를 데이터 압축 기술로 간주하는 동기에 기초하여, 그림 10.2의 화살표들을 인코더(encoder)와 디코더(decoder)를 나타내는 한 쌍의 연산으로 해석할 수 있다. $\boldsymbol{B}$ 로 표현되는 선형 사상은 저차원 코드 $\boldsymbol{z} \in \mathbb{R}^M$ 를 다시 원본 데이터 공간 $\mathbb{R}^D$ 로 매핑하는 디코더로 취급할 수 있다. 유사하게, $\boldsymbol{B}^\top$ 은 원본 데이터 $\boldsymbol{x}$ 를 저차원(압축된) 코드 $\boldsymbol{z}$ 로 인코딩하는 인코더로 취급할 수 있다.
행렬 $\boldsymbol{B}^\top$ 은 $M \times D$ 차원, $\boldsymbol{B}$ 는 $D \times M$ 차원이다. 합성된 투영 행렬 $\boldsymbol{P} = \boldsymbol{B}\boldsymbol{B}^\top$ 은 $D \times D$ 정방행렬의 형태를 가지지만, 랭크 정리( $\text{rank}(\boldsymbol{X}\boldsymbol{Y}) \le \min(\text{rank}(\boldsymbol{X}), \text{rank}(\boldsymbol{Y}))$ )에 의해 투영 행렬의 랭크는 최대 $M$ 으로 제약된다. 이는 행렬 $\boldsymbol{P}$ 가 $D$ 차원 공간에서 작동하는 연산자임에도 불구하고, 이를 통과하여 보존되는 정보의 자유도는 $M$ 차원으로 강제 축소됨을 증명한다. 이 $M$ 차원의 병목 구간이 원본 데이터 공간의 불필요한 분산(노이즈)을 소거하고 내재적 기하 구조(Intrinsic Geometry)만 통과시키는 필터로 기능한다.
$\quad$ 이 장 전반에 걸쳐, 우리는 MNIST 숫자 데이터셋을 반복적인 예제로 사용할 것이다. 이 데이터셋은 0부터 9까지의 손글씨 숫자 예제 60,000개를 포함한다. 각 숫자는 $28 \times 28$ 크기의 그레이스케일 이미지이다. 즉, 784개의 픽셀을 포함하므로 이 데이터셋의 모든 이미지를 벡터 $\boldsymbol{x} \in \mathbb{R}^{784}$ 로 해석할 수 있다. 이 숫자들의 예시가 그림 10.3에 나와 있다.
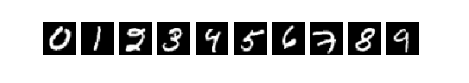
MNIST 데이터셋의 손글씨 숫자 예시.